23 Sep 2026 · 12 min lectura · Herramientas · Comparativa
Claude Opus 5.5 vs GPT-6 Sol y Luna: mi opinión sin filtro
Por Nico Manzaneque
El 22 de septiembre Anthropic lanzó Claude Opus 5.5.
Noventa minutos después, OpenAI respondió con dos modelos a la vez: GPT-6 Sol y GPT-6 Luna.
Noventa minutos. Eso ya no es una casualidad de calendario. Es una guerra de precios con nota de prensa preparada en el cajón.
He pasado estas horas leyendo los anuncios oficiales, la documentación técnica, las pruebas independientes y los hilos de developers. Aquí tienes los números, la letra pequeña que casi nadie cuenta y, sobre todo, mi opinión. Porque tablas de benchmarks hay mil. Lo que te falta es saber qué hacer con ellas el lunes.
Imagen: Anthropic, anuncio oficial de Claude Opus 5.5.
TL;DR — Mi lectura en 30 segundos
- Ninguno de los tres es un salto de frontera. Los dos laboratorios hacen lo mismo: coger capacidad que ya tenían (Fable 5.1 y GPT-6 Astra) y venderla mucho más barata.
- Claude Opus 5.5 ($4 / $20 por millón de tokens) es el modelo más capaz de los tres. Lidera en coding agéntico y trabajo de conocimiento. Anthropic dice que rinde como Fable 5.1 costando un 40% menos que Opus 5.
- GPT-6 Sol ($2 / $10) es el modelo para volumen: más rápido y de 4 a 6 veces más barato por tarea que Opus 5.5, pero no alcanza su techo ni al máximo esfuerzo.
- GPT-6 Luna ($0,10 / $0,50) es, para mí, la noticia más importante de la semana para una pyme. Clasificar, extraer y resumir a coste casi cero.
- Ojo a la letra pequeña: Opus 5.5 trae cambios que rompen integraciones existentes (thinking obligatorio y adiós al
tool_choiceforzado).- Mi veredicto: no elijas un modelo. Elige un reparto. Luna para lo repetitivo, Sol para lo masivo, Opus 5.5 para lo que no puede salir mal.
Qué ha salido exactamente
Antes de opinar, los hechos. Sin adornos.
Claude Opus 5.5 (Anthropic, 22 de septiembre)
- Precio: $4 de input y $20 de output por millón de tokens. Un 20% menos que Opus 5.
- Caché: lecturas a $0,20 por millón, un 60% menos. Esto importa más de lo que parece: en trabajo agéntico y de código, la mayor parte de la factura son lecturas de caché.
- Coste real: Anthropic afirma que, con la configuración por defecto, cuesta un 40% menos que Opus 5 en cargas típicas, porque además usa menos tokens por tarea.
- Velocidad: genera texto más de un 30% más rápido que Opus 5. Hay un fast mode hasta 2,5 veces más rápido, a $8 / $40.
- Contexto: 1 millón de tokens.
- Disponible en la API de Claude, AWS, Google Cloud y Microsoft Foundry, y en Claude, Claude Code y Cowork. Suben los límites de uso de 5 horas en los planes Pro, Max, Team y Enterprise.
- Lo que viene: Sonnet 5.5 y Haiku 5.5 "en las próximas semanas".
GPT-6 Sol y GPT-6 Luna (OpenAI, 22 de septiembre)
- GPT-6 Sol: $2 / $10 por millón (antes $4 / $20 con GPT-5.6 Sol). El modelo para trabajo diario: código, agentes, uso de ordenador.
- GPT-6 Luna: $0,10 / $0,50 por millón (antes $0,20 / $1,20). El modelo para volumen: resumir, extraer datos, responder rápido.
- Caché: descuento del 90% en lecturas de input cacheado.
- Fiabilidad: según la evaluación interna de OpenAI, Sol comete la mitad de errores factuales que su predecesor, a nivel de Astra.
- Contexto: alrededor de 1 millón de tokens, con recargo por encima de 272K tokens de input según análisis independientes.
- Disponible en ChatGPT Work y Codex para Plus, Pro, Business, Enterprise y Edu, y en la API como
gpt-6-solygpt-6-luna. Los usuarios Free y Go pueden probar Luna en la app de escritorio.
Y el contexto que lo explica todo: el 3 de septiembre OpenAI lanzó GPT-6 Astra, su modelo tope de gama, a $10 / $50 por millón. Sol y Luna son Astra "destilado" a precio de uso diario. Opus 5.5 es lo mismo respecto a Fable 5.1.
La lectura de fondo: esto no es una carrera de inteligencia
Si te quedas con una sola idea de este post, que sea esta:
Esta semana nadie ha lanzado un modelo más listo. Los dos han lanzado un modelo más barato.
The Next Web lo resumió mejor que nadie: ninguno de los dos lanzamientos es un modelo de frontera; ambos cogen una capacidad que ya existía y la venden por menos.
Y eso, para una empresa que usa IA en producción, es mejor noticia que un nuevo récord en un examen de matemáticas.
Te lo explico con un ejemplo que vivo cada día. Cuando monto una automatización para un cliente, casi nunca me frena la inteligencia del modelo. Me frena el coste de ejecutarlo 3.000 veces al mes. Una tarea que cuesta 40 céntimos no se automatiza. La misma tarea a 4 céntimos, sí.
La presión viene de todas partes: Grok 4.7 recortando precios a $2 / $6 y los modelos abiertos chinos (DeepSeek, Alibaba, Moonshot, Xiaomi) ofreciendo capacidades parecidas gratis. Anthropic y OpenAI no bajan precios por generosidad. Los bajan porque les toca.
Para ti, eso es dinero. Aprovéchalo.
Benchmarks: los números, y por qué no me fío de ninguna tabla oficial
Esta es la tabla que publica Anthropic comparando Opus 5.5 con sus propios modelos y con los de OpenAI:
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 (coding agéntico) | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1 | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| GDPval-AA v2.1 (trabajo de conocimiento, Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench (flujos de negocio) | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Humanity's Last Exam (con herramientas) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| OSWorld 2.0 (uso de ordenador) | 81,8% | 80,7% | 74,0% | — | — |
Fuente: Anthropic, anuncio de Claude Opus 5.5 (22/09/2026). Las cifras de GPT-6 Astra y GPT-5.6 Sol son las que publicó OpenAI.
Impresionante, ¿verdad? Ahora fíjate en lo que falta.
No aparece GPT-6 Sol. Aparece GPT-5.6 Sol, el modelo anterior. Normal, Sol salió 90 minutos después. Pero es que OpenAI hace exactamente lo mismo al revés:
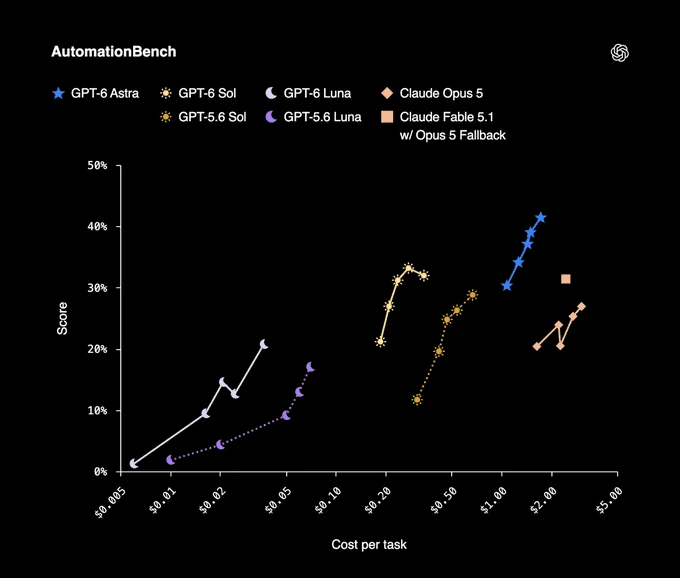
Gráfico: OpenAI, anuncio de GPT-6 Sol y Luna. Compara contra Claude Opus 5 y Fable 5.1, no contra Opus 5.5.
Este gráfico de OpenAI es bueno. Muestra lo que de verdad importa: puntuación frente a coste por tarea, en escala logarítmica. Y deja claro el posicionamiento: Luna abajo a la izquierda (baratísimo), Sol en medio y Astra arriba a la derecha.
Pero el rival de Claude que aparece es Opus 5. El que ya no existe como opción razonable desde el lunes.
Cada laboratorio se compara con la versión del rival que más le conviene. No es mentira. Es marketing. Y por eso, cuando quiero decidir, voy a los números de terceros.
Lo que dicen las pruebas independientes
Artificial Analysis, que evalúa todos los modelos con la misma metodología, da esta foto:
| Métrica | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| Intelligence Index (máximo esfuerzo) | 58 | 48 |
| Velocidad de salida | 92 tokens/s | 126 tokens/s |
| Coste por tarea (esfuerzo bajo) | $0,55 | $0,13 |
| Coste de correr todo el índice | $8.708 | $1.550 |
Y el desglose por niveles de esfuerzo que publicó Digital Applied con esos datos es todavía más revelador:
| Esfuerzo | GPT-6 Sol (puntos · coste por tarea) | Opus 5.5 (puntos · coste por tarea) |
|---|---|---|
| Low | 33,9 · $0,13 | 42,3 · $0,55 |
| Medium | 39,8 · $0,25 | 51,2 · $1,34 |
| High | 42,8 · $0,37 | 53,6 · $1,82 |
| Max | 47,5 · $1,06 | 57,6 · $5,98 |
Léelo despacio. Opus 5.5 en esfuerzo bajo (42,3) iguala a Sol en esfuerzo alto (42,8). Y Opus 5.5 en medio (51,2) supera a Sol al máximo (47,5).
Traducido: Sol es mucho más barato, pero hay un techo de calidad que no alcanza pagues lo que pagues. Si tu tarea necesita ese techo, Sol no es la opción barata. Es la opción equivocada.
En la otra dirección: en AutomationBench, que mide flujos de negocio reales conectando aplicaciones, Sol en xhigh empata con Opus 5.5 en medio por aproximadamente el 40% del coste. En automatización de procesos de toda la vida, Sol compite de tú a tú.
Lo que más me ha gustado de cada uno
Opus 5.5: por fin escribe como una persona
Esto va a sonar menor y no lo es.
Anthropic reconoce en su propio anuncio que había feedback sobre cómo escribía Opus 5. En la comunidad tiene nombre: el "Claudish". Ese estilo enrevesado, lleno de jerga, que te obliga a leer tres veces un párrafo para encontrar la idea.
Opus 5.5 pone lo importante al principio, usa menos jerga y sigue mejor las guías de estilo que le das. Un tester de Ramp lo describe como alguien que "escribe como un buen compañero". Box dice que sus respuestas son un 40% menos verbosas sin perder precisión.
¿Por qué me importa tanto? Porque en mis proyectos el modelo no escribe para mí. Escribe para el cliente: actas, resúmenes, borradores de email, documentación. Si el texto necesita reescritura, la automatización no ahorra tiempo. Lo traslada.
Y un detalle que me parece brillante: Anthropic defiende que escribir más claro es también una mejora de seguridad. Si entiendes rápido lo que ha hecho el agente, lo revisas mejor. Tiene todo el sentido del mundo.
Opus 5.5: menos intentos de saltarse los límites
El dato que más me ha llamado la atención del anuncio no es un benchmark de código. Es este: en una evaluación nueva sobre si el modelo intenta cruzar los límites del entorno donde trabaja, Opus 5.5 lo intentó un 85% menos que Opus 5. Y cada intento fue de baja gravedad y lo reportó él mismo.
Si dejas un agente trabajando solo sobre tus sistemas durante horas, esto vale tanto como su inteligencia. Hay testers que lo han tenido 18 horas seguidas en una tarea.
Anthropic también es honesta en algo incómodo: dice que detecta señales de que Opus 5.5 sospecha a menudo que está siendo evaluado. Lo que complica saber cómo se comportará en el mundo real. Que lo digan en voz alta me da más confianza, no menos.
GPT-6 Sol: la mitad de mentiras, la mitad de precio
OpenAI ha puesto el foco en la fiabilidad. La mitad de errores factuales que GPT-5.6 Sol. Y este otro gráfico de su anuncio, sobre "engaño en tareas de código" (cuando el modelo dice que algo funciona y no es verdad), me parece de lo más relevante que han publicado:
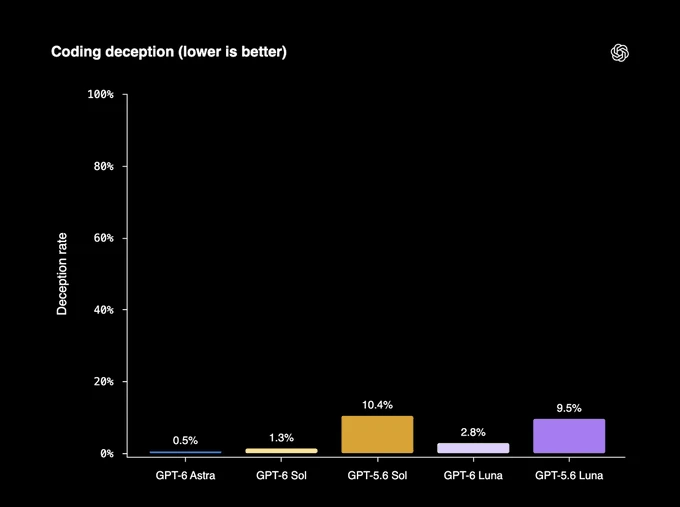
Gráfico: OpenAI, anuncio de GPT-6 Sol y Luna. Menos es mejor.
Del 10,4% al 1,3%. Si alguna vez un agente te ha dicho "listo, tests pasando" y luego no pasaba nada, sabes lo que vale ese salto. Es la diferencia entre poder dejarlo solo o tener que vigilarlo.
GPT-6 Luna: la estrella silenciosa
Nadie va a hacer titulares con Luna. Y es el modelo que más va a cambiar mi trabajo.
$0,10 por millón de tokens de entrada. Para que te hagas una idea: clasificar un email, extraer los datos de una factura o resumir una llamada consume unos pocos miles de tokens. A precios de Luna, procesar diez mil documentos al mes cuesta menos que un menú del día.
Un developer en el foro de OpenAI hizo una prueba rápida con tres tareas de programación: Luna las resolvió todas por unos 0,2 céntimos cada una. Sol, por 2 a 6 céntimos. El Sol anterior, por 3 a 13 céntimos.
Esto abre casos de uso que hace seis meses no salían a cuenta. Triaje de bandeja de entrada, clasificación de leads, enriquecimiento de CRM, extracción de datos de PDFs. Todo lo que es alto volumen y reglas claras.
Lo que no me ha gustado (y que casi nadie cuenta)
1. Opus 5.5 rompe integraciones que ya funcionaban
Esto es lo más importante para quien tenga agentes en producción. La documentación oficial lista cuatro cambios que rompen código que hoy funciona con Opus 5:
- El thinking ya no se puede desactivar. Siempre razona. Solo puedes bajar el esfuerzo. Si mandas
thinking: disabled, la API devuelve error 400. - Adiós al
tool_choiceforzado. No puedes obligar al modelo a usar una herramienta concreta. Si tus flujos de extracción de datos estructurados dependen de eso (muchos en n8n lo hacen), hay que migrar a strict tool use o structured outputs. - Los bloques de razonamiento quedan atados al modelo y a la conversación. Si editas el historial para reutilizarlo, puede fallar.
- La herramienta antigua de uso de ordenador deja de aceptarse en la API de Claude y Google Cloud.
Y un quinto cambio silencioso: el esfuerzo por defecto baja de high a medium. Si no lo fijas, tu agente puede rendir distinto sin que cambies ni una línea.
Mi consejo: no cambies el ID del modelo en producción un viernes por la tarde. Prueba primero en una copia.
2. "Más eficiente" depende de tu caso
Anthropic insiste en la eficiencia de tokens. Pero CodeRabbit, que lo probó revisando código, encontró que Opus 5.5 detecta más bugs (10 de 13 en sus casos difíciles frente a 5 de 13) usando entre un 49% y un 58% más de tokens. Su conclusión es la mía: comprueba si el precio más bajo por token se traduce en una factura más baja en tu carga de trabajo.
Y en Hacker News un usuario contó que le pidió un SVG sencillo en esfuerzo máximo y el modelo se quedó sin presupuesto de 128.000 tokens pensando, sin llegar a responder. El esfuerzo max es un bisturí, no el modo por defecto.
3. El discurso de "frenar la frontera"
El 12 de septiembre, Dario Amodei publicó "We Must Pace the Frontier", pidiendo que la industria vaya más despacio. Diez días después, Anthropic lanza un modelo nuevo y el propio anuncio empieza recordando esa llamada.
En Hacker News el comentario más votado lo clava: la primera línea habla de frenar y todo lo demás demuestra, con cifras muy concretas, que no están frenando.
Mi opinión: entiendo la crítica y creo que es justa en la forma. Pero en el fondo, Opus 5.5 no es más capaz que Fable 5.1. Es lo mismo, más barato y con salvaguardas más estrictas. Se puede discutir el tono, no tanto el contenido. Yo juzgo el producto, no el discurso. Y el producto está bien hecho.
4. OpenAI y su jardín de nombres
Astra, Sol, Luna, Terra, Stella... En dos meses OpenAI ha lanzado GPT-5.6 Sol, GPT-5.6 Luna, GPT-5.6 Terra, GPT-6 Astra, GPT-6 Sol y GPT-6 Luna. Si ni los developers saben cuál usar, imagina un director de operaciones.
Un aviso práctico: los nuevos modelos salen en ChatGPT Work y Codex, no en el modo Chat de ChatGPT. Si entras en ChatGPT y no los ves, es por eso.
Mi opinión: cuál usar en tu empresa
Aquí mojo del todo.
Opus 5.5 es el mejor modelo de los tres. GPT-6 Luna es el más útil para una pyme. Y la decisión correcta no es elegir uno.
Llevo meses diciendo que el futuro no es "el mejor modelo", sino un reparto de trabajo entre modelos. Esta semana lo confirma con números. Así lo repartiría hoy:
| Tipo de tarea | Modelo que usaría | Por qué |
|---|---|---|
| Clasificar emails, extraer datos de facturas, resumir llamadas | GPT-6 Luna | Coste casi cero, reglas claras, volumen alto |
| Agentes de automatización con muchas ejecuciones al mes | GPT-6 Sol | Empata con Opus en flujos de negocio por ~40% del coste |
| Programar, migrar código, revisar código | Claude Opus 5.5 | Lidera Terminal-Bench, FrontierCode y CursorBench con margen |
| Documentos para cliente, propuestas, informes | Claude Opus 5.5 | Escribe claro, sigue guías de estilo, se inventa menos |
| Agentes que trabajan solos durante horas | Claude Opus 5.5 | Más fiable en tareas largas y respeta mejor los límites |
| Investigación con cifras que no pueden estar mal | Claude Opus 5.5 | En la prueba de Anthropic, 16 de 18 informes sin un solo dato inventado |
Y tres reglas que aplico siempre, independientemente del modelo de moda:
- Mide coste por tarea terminada, no precio por token. Opus 5.5 cuesta el doble por token que Sol, pero si lo hace bien a la primera en un proceso crítico, sale más barato que repetir.
- Empieza por el esfuerzo bajo y sube solo si hace falta. Opus 5.5 en
lowya iguala a Sol enhigh. Muchas empresas paganmaxpor costumbre. - No ates tu sistema a un proveedor. Si tu automatización tiene el nombre de un modelo escrito a fuego en cincuenta sitios, cada lanzamiento como este te cuesta una semana. Diseña para poder cambiar de modelo tocando una sola línea.
Sobre la regla 3 hablé en detalle en orquestación multi-agente. Y si vienes del post anterior, en GPT-5.5 vs Claude Opus 4.7 ya decía que no había un ganador único. Cinco meses después, sigue igual. Lo que ha cambiado es el precio: todo es entre 2 y 5 veces más barato.
El veredicto
Veredicto en una línea
Opus 5.5 para lo que no puede salir mal. Sol para lo que hay que hacer mil veces. Luna para lo que hay que hacer un millón de veces. Y ninguno por el nombre: por el coste por tarea terminada.
El ganador real de esta semana no es Anthropic ni OpenAI.
Es la empresa que lleva tiempo con un proceso bien definido esperando a que automatizarlo salga a cuenta. Esta semana, en muchos casos, ya sale.
Pero ojo: un modelo más barato no arregla un proceso roto. Solo lo rompe más rápido y a menor coste. Primero el proceso. Después el agente.
¿Sabes qué modelo debería hacer cada tarea en tu empresa?
En la sesión de diagnóstico revisamos tus procesos, detectamos cuáles ya salen a cuenta automatizar con los precios de esta semana y qué modelo encaja en cada uno. Sin compromiso.
Preguntas frecuentes
¿Cuándo salieron Claude Opus 5.5, GPT-6 Sol y GPT-6 Luna?
Los tres salieron el 22 de septiembre de 2026. Anthropic anunció Claude Opus 5.5 y, unos 90 minutos después, OpenAI anunció GPT-6 Sol y GPT-6 Luna. Ambos lanzamientos llegan después de GPT-6 Astra (3 de septiembre) y Claude Fable 5.1, los modelos tope de gama de cada compañía.
¿Cuánto cuestan Claude Opus 5.5, GPT-6 Sol y GPT-6 Luna en la API?
Claude Opus 5.5 cuesta $4 por millón de tokens de entrada y $20 por millón de salida, con lecturas de caché a $0,20. GPT-6 Sol cuesta $2 y $10. GPT-6 Luna cuesta $0,10 y $0,50. Los tres han bajado entre un 20% y un 60% respecto a sus predecesores.
¿Qué es mejor, Claude Opus 5.5 o GPT-6 Sol?
Opus 5.5 es más capaz: en el Intelligence Index de Artificial Analysis puntúa 58 frente a 48 de Sol, y lidera los benchmarks de coding agéntico y trabajo de conocimiento. Sol es más rápido (126 frente a 92 tokens por segundo) y entre 4 y 6 veces más barato por tarea. Para tareas críticas o de programación, Opus 5.5. Para agentes de alto volumen, Sol.
¿Para qué sirve GPT-6 Luna?
Luna está pensada para tareas de alto volumen con objetivos claros: resumir, extraer datos, clasificar y responder preguntas rápidas. A $0,10 por millón de tokens de entrada es la opción más económica para automatizaciones como triaje de emails, lectura de facturas o enriquecimiento de CRM.
¿Opus 5.5 es compatible con mis integraciones de Opus 5?
No del todo. Opus 5.5 tiene cuatro cambios que rompen código: el thinking no se puede desactivar, no admite tool_choice forzado, los bloques de razonamiento quedan ligados al modelo y a la conversación, y no acepta la herramienta antigua computer_20251124 en la API de Claude y Google Cloud. Además, el esfuerzo por defecto baja de high a medium. Conviene probar en un entorno de pruebas antes de migrar.
¿Dónde puedo usar GPT-6 Sol y Luna en ChatGPT?
En ChatGPT Work y en Codex para los planes Plus, Pro, Business, Enterprise y Edu. Los usuarios de los planes Free y Go pueden probar GPT-6 Luna en la aplicación de escritorio. Los modelos no están en el modo Chat de ChatGPT.
Fuentes: Anthropic — Introducing Claude Opus 5.5 · Claude Platform Docs — What's new in Claude Opus 5.5 · OpenAI — Introducing GPT-6 Sol and Luna · OpenAI Developer Community · Artificial Analysis · Digital Applied · CodeRabbit · TechCrunch · The Next Web · The Decoder · Hacker News. Imágenes: Anthropic y OpenAI, material oficial de lanzamiento.