27 Abr 2026 · 14 min lectura · Herramientas · Comparativa
GPT-5.5 vs Claude Opus 4.7: La Semana que OpenAI Alcanzo a Anthropic
Por Nico Manzaneque
Siete dias de diferencia entre lanzamientos. Diez benchmarks disputados. Una narrativa que llevaba 18 meses estable y que acaba de romperse: en agentic coding, Codex 5.5 ya no esta por detras de Claude. Esto es lo que cambia, lo que no, y como decidir cual modelo va a tu stack.
TL;DR — Puntos clave
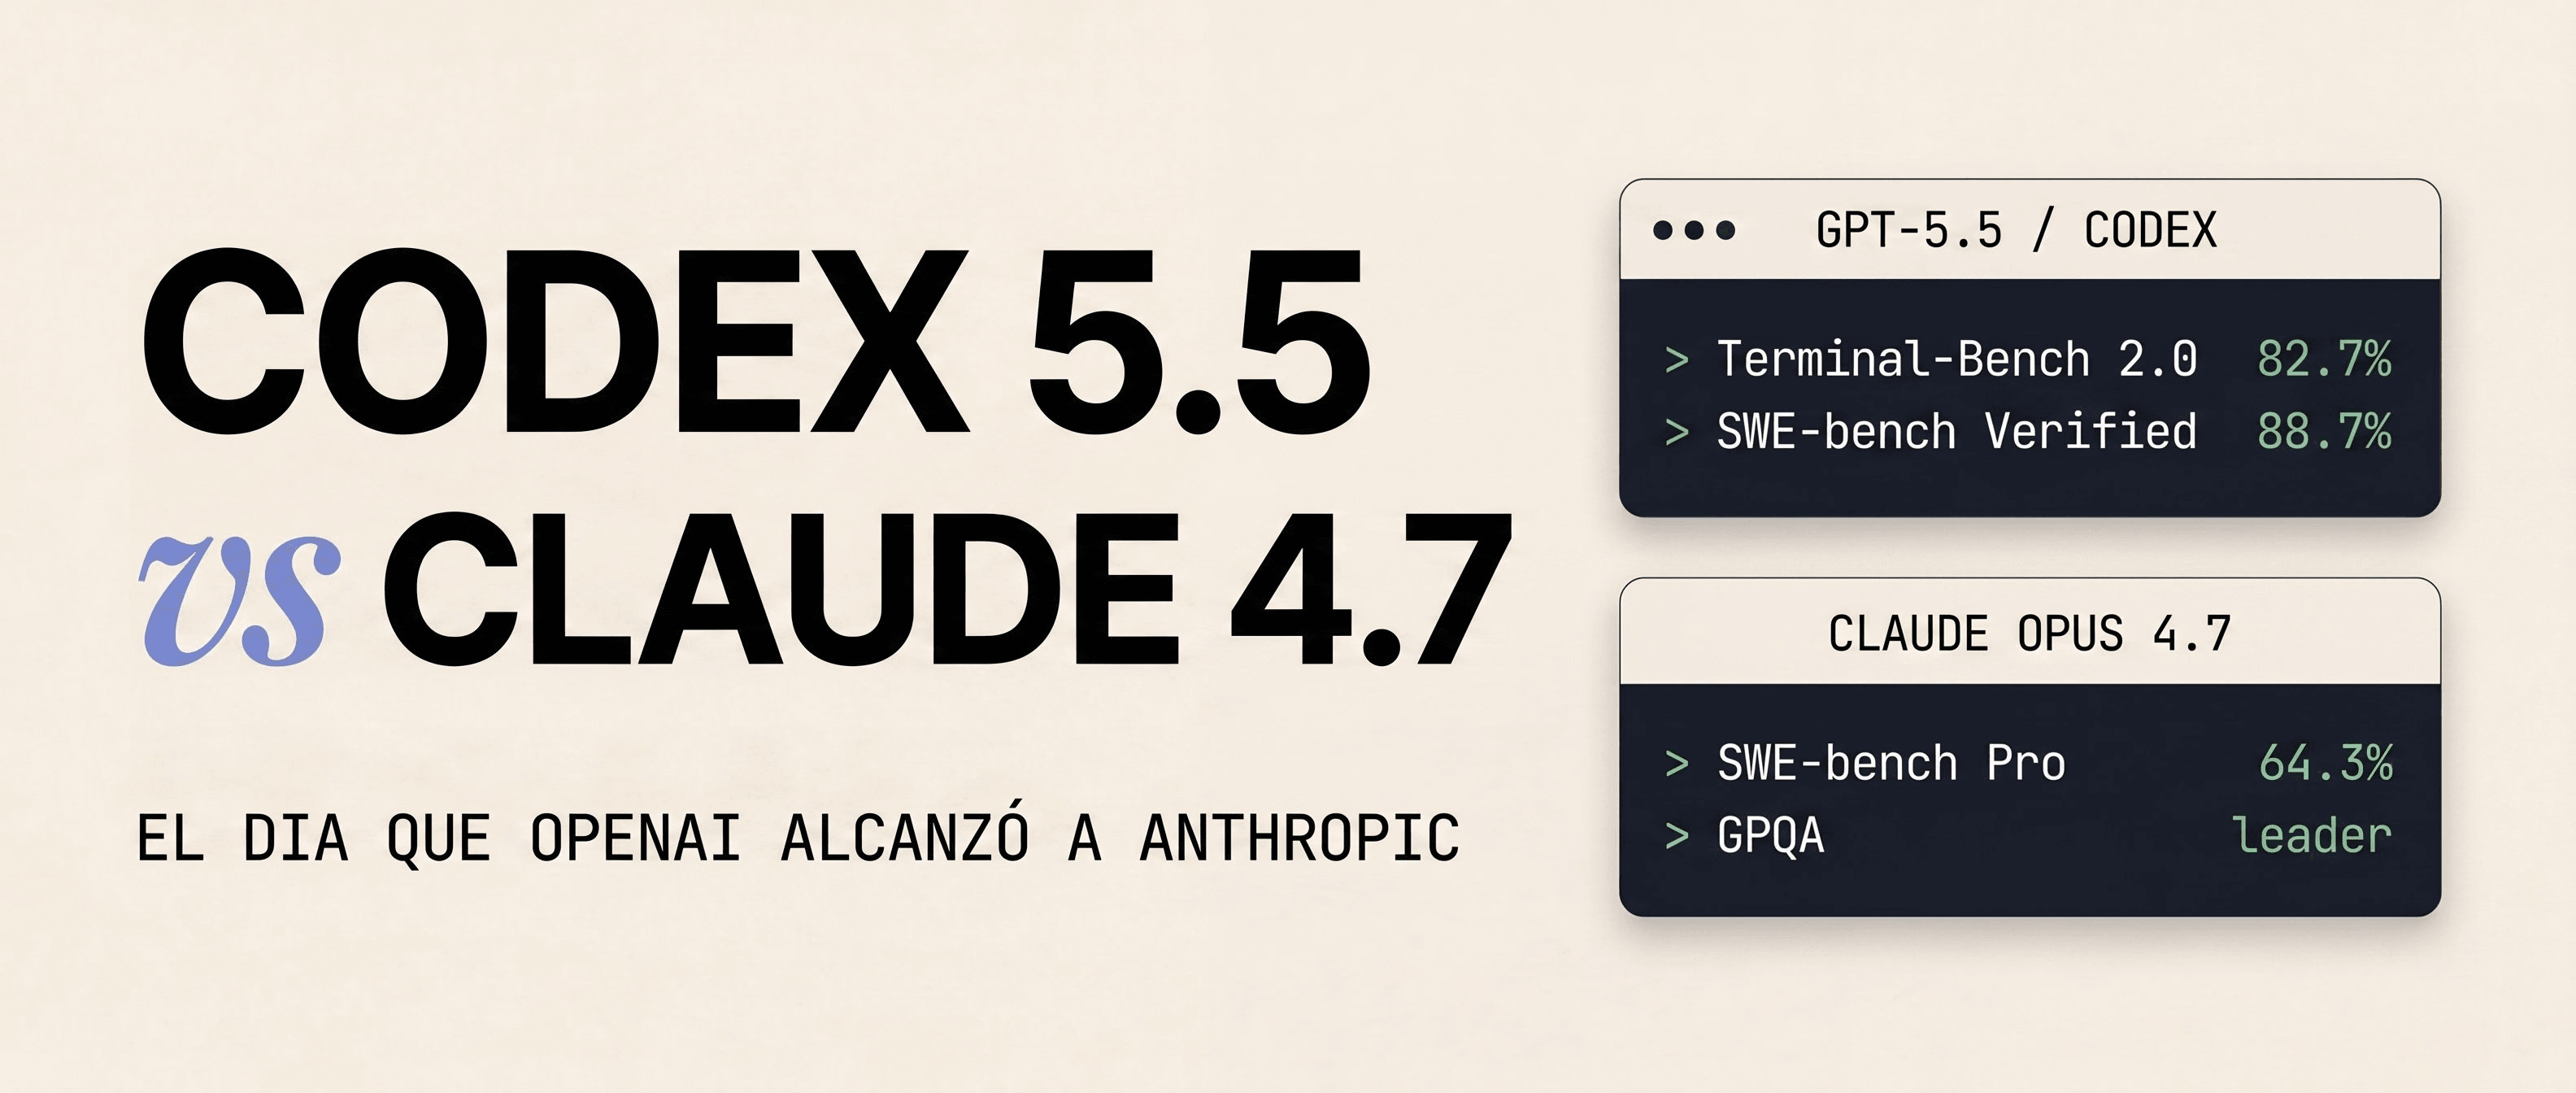
- Claude Opus 4.7 (16 abril) lidera 6 de 10 benchmarks: razonamiento, complejidad multi-archivo, review de codigo. SWE-bench Pro: 64.3%.
- GPT-5.5 "Spud" (23 abril) lidera 4 de 10: agentic, terminal y workflows largos. Terminal-Bench 2.0: 82.7%. SWE-bench Verified: 88.7%.
- Eficiencia de tokens: GPT-5.5 usa 72% menos output tokens por tarea. Opus 4.7 estrena tokenizer que produce hasta 35% mas tokens por el mismo texto.
- Precios API: input $5/M ambos. Output Opus $25/M, GPT-5.5 $30/M. En coste real por tarea, GPT-5.5 suele salir mas barato.
- Contexto: empate en 1M input / 128K output. Primera vez que OpenAI iguala a Anthropic en ventana.
- Veredicto: ya no hay un modelo "mejor para coding". Hay un modelo mejor para cada tipo de tarea de coding.
La premisa: una semana, dos modelos, un cambio de mapa
Durante 18 meses, la formula entre cualquier developer serio fue la misma: Claude para coding, GPT para todo lo demas. Anthropic dominaba SWE-bench, Claude Code se convirtio en el estandar de facto para agentic coding y Opus se apellidaba "el mejor modelo de coding del mundo".
El 16 de abril de 2026, Anthropic lanzo Claude Opus 4.7: un upgrade focalizado que empujo SWE-bench Pro de 53.4% (Opus 4.6) a 64.3%. Todos asumimos que la brecha se ampliaba.
Siete dias despues, OpenAI saco GPT-5.5 (nombre interno: Spud): el primer modelo base completamente reentrenado desde GPT-4.5. No fue un patch. Fue una respuesta directa.
"El mapa que dabamos por estable se redibujo en 7 dias. Y por primera vez desde el lanzamiento de Claude 3.5 Sonnet, no hay un ganador unico en coding."
El proposito de este post: ir benchmark a benchmark, cifra a cifra, y dejarte una matriz de decision util en lugar de un veredicto plano. Si solo lees el TL;DR de arriba, ya tienes 90% del valor. Si quieres entender por que y cuando, sigue.
La comparativa en 6 dimensiones
Antes de profundizar, este resumen visual. Si solo tienes 30 segundos, esta tabla es lo que importa.
| Dimension | GPT-5.5 (Spud) | Claude Opus 4.7 |
|---|---|---|
| Razonamiento puro | Solido | Lider (GPQA, HLE) |
| Coding agentico | Lider (Terminal-Bench, OSWorld) | Solido |
| Refactors complejos | Bueno | Lider (SWE-bench Pro) |
| Eficiencia tokens | Lider (-72%) | +35% nuevo tokenizer |
| Precio output ($/M) | $30 | $25 |
| Ventana contexto | 1M / 128K | 1M / 128K |
Fuentes: Anthropic Model Card (16 abril 2026), OpenAI System Card GPT-5.5 (23 abril 2026), llm-stats.com.
Benchmarks: los 10 numeros que importan
De los 10 benchmarks principales reportados por ambos proveedores, Opus 4.7 lidera 6 y GPT-5.5 lidera 4. Pero el donde lidera cada uno es la parte interesante.
SWE-bench: el benchmark partido en dos
SWE-bench Verified mide la capacidad de resolver issues reales de GitHub en repos de un solo archivo o de complejidad moderada. Aqui GPT-5.5 toma la corona por un margen estrecho:
| Benchmark | Resultado | Ganador |
|---|---|---|
| SWE-bench Verified | 88.7% | GPT-5.5 · vs 87.6% de Opus 4.7 |
| SWE-bench Pro (multi-file) | 64.3% | Opus 4.7 · vs 58.6% de GPT-5.5 |
Lectura: GPT-5.5 ejecuta mejor cuando la tarea esta acotada y requiere precision en herramientas y navegacion de archivos. Opus 4.7 mantiene su ventaja cuando hay que razonar a traves de multiples archivos y entender arquitectura. La diferencia no es estilistica — es de naturaleza del modelo.
Terminal-Bench 2.0: el ariete de OpenAI
Aqui es donde GPT-5.5 marca el cambio mas claro. En Terminal-Bench 2.0 — el benchmark que mide workflows complejos de linea de comandos, multi-step y con tool-use sostenido — alcanza un 82.7%, claramente por delante de Opus 4.7. Y este es exactamente el dominio que Claude Code venia dominando.
En la misma linea, OSWorld-Verified (operacion de sistema operativo completo), BrowseComp (navegacion web autonoma) y CyberGym (tareas de seguridad) tambien caen del lado de GPT-5.5. Lo que tienen en comun: secuencias largas de tool-use con feedback iterativo.
Razonamiento: la fortaleza inalterada de Anthropic
En benchmarks de razonamiento puro, Opus 4.7 sigue arriba:
- GPQA Diamond (razonamiento cientifico grado-PhD): Opus 4.7 lider.
- HLE (Humanity's Last Exam) sin herramientas: Opus 4.7 lider.
- HLE con herramientas: Opus 4.7 lider.
- MCP Atlas (uso de Model Context Protocol en tareas reales): Opus 4.7 lider.
- FinanceAgent v1.1 (razonamiento cuantitativo financiero): Opus 4.7 lider.
Patron: cuando la tarea exige cadenas de razonamiento largas sin feedback intermedio, Anthropic mantiene su ventaja estructural. Cuando hay un terminal, un browser o un sandbox para iterar — OpenAI gana.
Codex CLI vs Claude Code: el dia a dia del developer
Los benchmarks pintan el techo de capacidad. Pero la experiencia real del developer la define el harness — la CLI, los hooks, los slash commands, la integracion con MCP. Aqui es donde Claude Code llevaba 18 meses sin rival serio. Ya no.
Lo que Codex CLI ha alcanzado
La version actual de Codex CLI (con GPT-5.5) cierra los gaps que llevaban 12 meses abiertos:
- Plan mode equivalente: separa fase de planning de fase de ejecucion, con preview de cambios antes de aplicar.
- Hooks de pre/post tool use: permite interceptar comandos shell, validar diffs y disparar triggers personalizados.
- Soporte MCP nativo: servidores Model Context Protocol funcionan tal cual los configuraste para Claude Code.
- Slash commands con argumentos posicionales y deteccion de contexto.
- Eficiencia: 72% menos output tokens en las mismas tareas significa que sesiones largas con cache caliente ya no te queman el presupuesto.
Donde Claude Code sigue siendo superior
Honestidad intelectual obliga: hay zonas donde Claude Code todavia no tiene rival.
- Sub-agentes y orquestacion interna: el sistema de Task tool con sub-agentes especializados sigue siendo mas refinado que su contraparte en Codex.
- Refactors largos sin perder hilo: el horizonte de planificacion sostenida (long-horizon agentic workflows) en tareas de 30+ pasos sigue del lado de Opus.
- Integraciones IDE: el plugin VS Code y la integracion JetBrains tienen mas anos de pulido.
- Skills system: el sistema de skills declarativas con triggers, permisos y descubrimiento es unico de Claude.
- Output writing: para documentacion, explicaciones tecnicas y commits, Opus 4.7 sigue produciendo prosa mas natural y precisa.
"Codex CLI con GPT-5.5 ya es una herramienta de primera. No es todavia mejor que Claude Code en todos los frentes, pero por primera vez la pregunta tiene matiz."
Si quieres profundizar en como un developer real combina ambos en su flujo, escribimos sobre eso en Terminales con IA: Antigravity, Warp y la nueva generacion y en Agentes en Antigravity + Claude Code.
Cloud, sandboxes y agentes paralelos
La parte del ecosistema que mas cambia con GPT-5.5 es Codex Cloud. La idea: lanzar agentes que corran tareas largas en sandboxes remotos sin ocupar tu terminal local. Es donde la eficiencia de tokens y la velocidad de tool-use de GPT-5.5 se sienten mas.
Caso real
Migracion de un monorepo de TypeScript: 47 paquetes, upgrade de React 18 a React 20, ajustes de tipos en 1.200 archivos. Lanzas 5 agentes en paralelo en Codex Cloud, cada uno responsable de un grupo de paquetes. Tiempo total real: 2h 40m. Coste API: ~$18.
El mismo trabajo en Claude Code local con Opus 4.7 se completaria en ~4h con un coste estimado de ~$32 (debido a mas output tokens y al overhead del nuevo tokenizer).
Anthropic tiene su propia respuesta — Claude Code Cloud y la integracion con Sonnet web — pero a fecha de este post, la paralelizacion masiva con sandboxing granular esta mas pulida en Codex Cloud. Esto cambiara, pero hoy es asi.
Precios reales: el numero que importa no es el de la web
En la pagina de pricing de cada proveedor:
| GPT-5.5 | Claude Opus 4.7 | |
|---|---|---|
| Input | $5 / M tokens | $5 / M tokens |
| Output | $30 / M tokens | $25 / M tokens |
| Cache hit | $0.50 / M tokens | $0.50 / M tokens |
| Batch API | 50% descuento | 50% descuento |
En output, Opus 4.7 es ~17% mas barato. Pero hay dos efectos compensatorios que cambian el calculo real:
- Eficiencia de output (GPT-5.5): en tareas equivalentes, GPT-5.5 produce 72% menos tokens de output. A precio nominal mas alto, sigue saliendo mas barato en la factura final.
- Tokenizer Opus 4.7: Anthropic estreno un tokenizer nuevo que, segun reportes, produce hasta 35% mas tokens para el mismo texto de entrada en lenguajes no-ingles. Esto infla input tokens y cache.
Resultado neto: pese a que el precio nominal de Opus es mas bajo, en muchos workloads reales (sobre todo coding agentico con ciclos largos de tool-use) GPT-5.5 termina costando menos. La regla "Anthropic siempre es mas caro" del 2025 ya no aplica — pero el flip tampoco. Hay que medir tu caso.
Recomendacion practica
No optimices precio de la web. Mide coste por tarea completada en tu workload real con cache caliente. Las diferencias son del 10-30% y dependen completamente de tu uso. Para muchos equipos, el coste de eleccion mal medida supera el ahorro nominal.
Donde Claude Opus 4.7 sigue siendo la mejor eleccion
El titular de "Codex alcanzo a Claude" es real, pero reduccionista. Hay seis tipos de tarea donde elegir Opus 4.7 sigue siendo la decision correcta sin discusion:
- Refactors arquitectonicos multi-archivo — Mover una capa de persistencia, reorganizar dominios DDD, consolidar duplicacion: SWE-bench Pro 64.3% lo dice. Opus mantiene mejor el grafo mental del proyecto.
- Razonamiento cientifico y financiero — GPQA, HLE, FinanceAgent. Si tu producto razona sobre datos duros sin feedback iterativo, Opus es la apuesta segura.
- Documentacion tecnica y writing — Explicaciones claras, tono consistente, prosa que no necesite re-escritura. Opus 4.7 sigue siendo el mejor generador de prosa tecnica.
- Code review y QA — Detectar bugs sutiles, edge cases y cuestiones de diseño. La capacidad de "review-grade" de Opus sigue siendo diferencial.
- Long-horizon agentic workflows (30+ pasos) — Cuando el agente debe sostener contexto y planificacion durante muchas iteraciones, Opus mantiene mejor el hilo.
- MCP servers complejos — MCP Atlas lo confirma. Si tu integracion depende de orquestar 5+ MCP servers heterogeneos, Opus razona mejor sobre cuando usar cada uno.
Donde GPT-5.5 es ahora la mejor eleccion
Y por simetria — los seis dominios donde el cambio de pesos ya esta hecho:
- Workflows shell-driven y operacion de SO — Terminal-Bench 2.0 (82.7%) y OSWorld-Verified. Todo lo que sea cadenas largas de comandos, scripting, automatizacion sysadmin: GPT-5.5.
- Web automation y browsing autonomo — BrowseComp lo refleja: scraping inteligente, llenar formularios, navegar sites complejos. La API de Browser de OpenAI es la mas pulida.
- Agentes paralelos en cloud — Codex Cloud + sandboxing + paralelismo. Para tareas "fire-and-forget" en lotes grandes, hoy gana.
- SWE-bench Verified (issues acotados) — 88.7%. Bug fixes y features puntuales con scope claro: GPT-5.5 ejecuta mas rapido y con menos tokens.
- Workloads de alto volumen agentico — Si tu producto hace 10K+ calls diarias con tool-use, el 72% menos de output tokens convierte la decision en una cuestion de margen, no de gusto.
- Tareas de seguridad ofensiva (CTF, pentest legal) — CyberGym lo confirma. GPT-5.5 enlaza mejor cadenas de reconocimiento, exploracion y exploitation con tool-use en sandbox.
Matriz de decision: cual eligir segun tu caso
Si tienes que decidir hoy, sin medir tu workload, esta es la heuristica que estoy aplicando con clientes en consultoria.
| Tu situacion | Eleccion por defecto |
|---|---|
| Equipo de coding humano + IA, refactors complejos | Claude Opus 4.7 |
| Pipeline de agentes con 1000+ tareas/dia | GPT-5.5 |
| Producto con razonamiento cientifico/financiero | Claude Opus 4.7 |
| Web scraping y automatizacion de browsers | GPT-5.5 |
| Generacion de documentacion y contenido tecnico | Claude Opus 4.7 |
| Sysadmin / DevOps / shell automation | GPT-5.5 |
| Code review automatizado en PRs | Claude Opus 4.7 |
Si te fijas, no hay una eleccion universal. Hay una eleccion por dominio. Esto deberia cambiar como diseñas tu stack:
"El futuro a 12 meses no es 'modelo unico para todo'. Es arquitectura modular con un router que decide por tarea."
Esto se conecta directamente con lo que escribimos sobre orquestacion multi-agente: si tu producto manda toda la carga al mismo modelo, ya estas pagando 20-40% mas por peor calidad en al menos 30% de tus tareas.
Que implica este cambio para tu stack
Si llevas 18 meses con Claude como eleccion por defecto en todo, hay tres cosas que probablemente debes revisar este mes:
1. Re-evalua tu workload de agentic
Si tienes pipelines automatizados con tool-use largo o agentes que corren en sandboxes — crea una rama de prueba con GPT-5.5 y mide en el mismo workload. La diferencia en factura mensual puede ser sustancial.
2. No muevas tu coding humano todavia
Para developers humanos usando Claude Code dia a dia, no hay razon urgente para cambiar. La experiencia, los hooks, los skills y la calidad de razonamiento siguen del lado de Anthropic. La paridad es en agentic, no en interactivo.
3. Diseña para multiples modelos desde ahora
Si tu codigo tiene anthropic.messages.create(...) hard-codeado, este es el momento de abstraerlo. Un router de modelos por tipo de tarea va a ser estandar en 6 meses. Equipos que lo tengan hoy van a iterar mas rapido y pagar menos.
Anthropic no se queda quieta. Sonnet 4.7 esta confirmado para Q3 2026 y rumores apuntan a Opus 4.8 con mejoras especificas en agentic. La carrera no para — pero por primera vez en 18 meses, OpenAI esta delante en algunos frentes.
Veredicto: que cambio realmente
La narrativa "Claude es mejor para coding" murio el 23 de abril de 2026. La sustituye una mas matizada y mas util:
Veredicto en una linea
Para razonamiento y refactors complejos, Claude Opus 4.7. Para agentic, terminal y volumen, GPT-5.5. Para todo lo demas, mide.
El verdadero ganador de esta semana no es OpenAI ni Anthropic. Es el developer que entiende que ya no hay un modelo "mejor" — hay un modelo mejor para cada tipo de tarea, y la ventaja competitiva real esta en saber elegir rapido y barato.
Si tu producto delega esa eleccion al mismo modelo siempre, estas dejando dinero y calidad en la mesa todos los dias. Si la delegas a un router que entienda tipos de tarea, acabas de ganar 6-12 meses de ventaja.
¿Tu stack usa el modelo correcto en cada tarea?
En la auditoria gratuita revisamos tu uso actual de modelos, identificamos donde estas pagando de mas o perdiendo calidad, y te dejamos un plan concreto para arquitectura modular. 15 minutos. Sin compromiso.
Preguntas frecuentes
¿Quien gana en SWE-bench, GPT-5.5 o Claude Opus 4.7?
Depende del benchmark. En SWE-bench Verified gana GPT-5.5 con 88.7% vs 87.6% de Opus 4.7. En SWE-bench Pro (multi-archivo, mas dificil) gana Claude Opus 4.7 con 64.3% vs 58.6%. GPT-5.5 destaca en tareas de tool-use preciso y navegacion de archivos; Opus 4.7 destaca en razonamiento arquitectonico sobre codebases grandes.
¿Cual es mas barato, GPT-5.5 o Claude Opus 4.7?
Ambos cobran $5 por millon de tokens de input. En output, Opus 4.7 esta a $25/M y GPT-5.5 a $30/M, ~20% mas caro. Pero el nuevo tokenizer de Opus genera hasta 35% mas tokens por el mismo texto, y GPT-5.5 usa 72% menos tokens de output en tareas equivalentes. Resultado: en coste real por tarea, GPT-5.5 suele salir mas barato pese al precio nominal mas alto.
¿GPT-5.5 ha superado a Claude en coding?
En agentic coding (Terminal-Bench 2.0, OSWorld-Verified, BrowseComp) y eficiencia de tokens si. En razonamiento puro (GPQA, HLE) y refactors complejos multi-archivo (SWE-bench Pro), Opus 4.7 sigue ganando. De los 10 benchmarks principales, Opus 4.7 lidera 6 y GPT-5.5 lidera 4. La narrativa de paridad es real, pero cada modelo tiene su zona de fortaleza.
¿Cual ventana de contexto tienen GPT-5.5 y Claude Opus 4.7?
Ambos modelos ofrecen 1.000.000 tokens de contexto de input y 128.000 tokens de output en la API estandar. Es la primera generacion en la que OpenAI y Anthropic estan empatados en ventana de contexto: hasta abril de 2026, Anthropic lideraba con su 1M context.
¿Cuando salieron GPT-5.5 y Claude Opus 4.7?
Anthropic lanzo Claude Opus 4.7 el 16 de abril de 2026 con un salto importante en SWE-bench Pro (de 53.4% en 4.6 a 64.3% en 4.7). OpenAI lanzo GPT-5.5 (nombre interno Spud) el 23 de abril de 2026, primer modelo base completamente reentrenado desde GPT-4.5.
¿Que es mejor, Codex CLI o Claude Code?
Claude Code sigue siendo mas pulido en hooks, slash commands y MCP servers, ademas del manejo de planes largos. Codex CLI con GPT-5.5 ha alcanzado paridad en autonomia y supera en eficiencia de tokens y velocidad de ejecucion shell. Para flujos largos con multiples herramientas, Codex CLI esta a la altura. Para refactors arquitectonicos con razonamiento sostenido, Claude Code aun es preferible.