5 Mar 2026 · 11 min lectura · Inteligencia Artificial
RAG Empresarial: Conecta tu IA con los Datos Reales de tu Empresa
Por Nico Manzaneque
Tu empresa ya usa ChatGPT o Claude, pero le das datos genéricos y recibes respuestas genéricas. RAG (Retrieval-Augmented Generation) es la pieza que falta: conecta tu IA directamente con los documentos, procesos y datos internos de tu negocio. Resultado: respuestas precisas, cero inventos, y un sistema que realmente entiende tu empresa.
Por qué ChatGPT y Claude NO son suficientes para tu empresa
La mayoría de empresas empiezan igual: alguien del equipo descubre ChatGPT, lo usa para redactar emails y generar contenido, y piensa "esto podría automatizar media empresa". Tiene razón en el potencial, pero se equivoca en la ejecución.
Los modelos de IA generalistas tienen un problema fundamental: no conocen tu empresa. No saben cuáles son tus productos, tus políticas de devolución, tus procesos internos ni los datos de tus clientes. Y cuando les preguntas algo específico, hacen lo que mejor saben: inventar. En el mundo de la IA se llaman "alucinaciones", y según un estudio de Vectara Research, los modelos de lenguaje alucinan entre un 3% y un 27% de las veces dependiendo de la tarea.
El gap entre IA genérica e IA útil para negocios
Para que la IA sea realmente útil en tu empresa, necesita acceso a tres cosas:
- Datos internos actualizados: manuales, procesos, FAQs, documentación técnica, historial de tickets
- Contexto específico: quién es el cliente que pregunta, qué producto tiene, cuál es su historial
- Límites claros: que responda solo con información verificada y diga "no lo sé" cuando no tiene datos
Aquí es exactamente donde entra RAG — Retrieval-Augmented Generation. No es una herramienta nueva. Es una arquitectura que transforma cualquier modelo de IA en un asistente que realmente conoce tu negocio.
¿Qué es RAG? Explicado sin jerga técnica
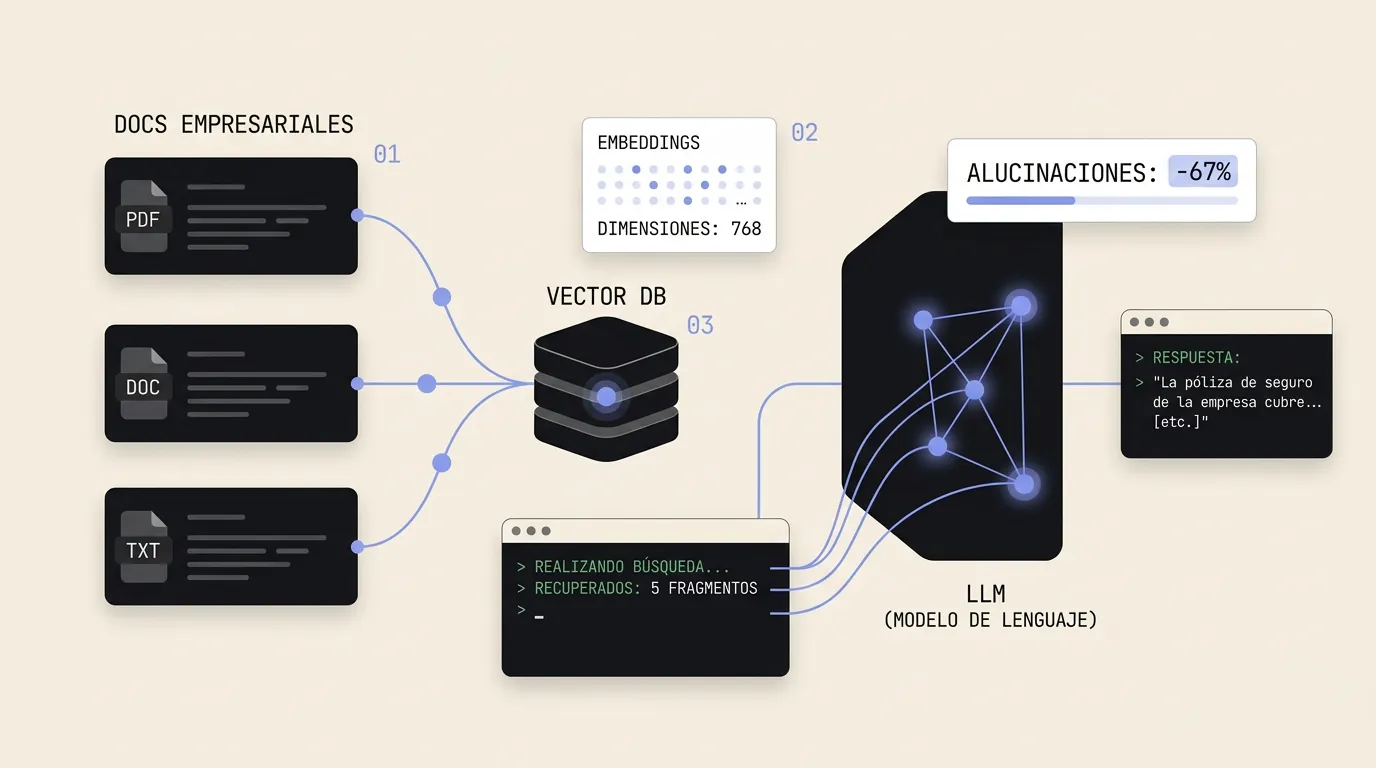
RAG (Retrieval-Augmented Generation) es un patrón de arquitectura que añade una capa de "memoria empresarial" a cualquier modelo de IA. En lugar de que el modelo responda solo desde su entrenamiento genérico, primero busca información relevante en tus datos internos y luego genera una respuesta basada en esa información real.
Piénsalo así: si ChatGPT es un consultor muy listo pero que acaba de llegar a tu empresa, RAG es darle acceso al archivo completo de la empresa antes de que responda cualquier pregunta.
Los 4 pasos de un sistema RAG
- Ingestión: tus documentos internos (PDFs, manuales, wikis, datos del CRM) se procesan y se dividen en fragmentos manejables — lo que se llama "chunking"
- Embeddings: cada fragmento se convierte en un vector numérico que captura su significado semántico. Esto permite buscar por significado, no solo por palabras clave
- Recuperación (Retrieval): cuando un usuario hace una pregunta, el sistema busca los fragmentos más relevantes en la base vectorial — los que mejor responden a esa pregunta específica
- Generación (Generation): el modelo de IA recibe la pregunta original junto con los fragmentos recuperados, y genera una respuesta fundamentada en datos reales de tu empresa
RAG vs. Fine-tuning vs. Prompt Engineering
| Enfoque | Qué hace | Cuándo usarlo |
|---|---|---|
| Prompt Engineering | Instrucciones detalladas al modelo | Tareas simples, poco contexto necesario |
| Fine-tuning | Reentrenar el modelo con tus datos | Cambiar estilo/comportamiento del modelo |
| RAG | Conectar el modelo a tus datos en tiempo real | Conocimiento interno, datos que cambian, precisión |
Según IBM Research, RAG es el enfoque recomendado para el 80% de los casos de uso empresariales porque combina la flexibilidad de un modelo generalista con la precisión de datos internos, sin necesidad de reentrenar modelos.
Embeddings y bases de datos vectoriales: la infraestructura detrás de RAG
Para que RAG funcione, necesitas dos piezas técnicas fundamentales: un modelo de embeddings que convierta texto en vectores y una base de datos vectorial que almacene y busque esos vectores de forma eficiente.
¿Qué son los embeddings?
Un embedding es una representación numérica del significado de un texto. Convierte frases como "política de devoluciones para productos defectuosos" en un array de números (un vector de 1536 dimensiones, por ejemplo) que captura su significado semántico. Dos textos con significado similar tendrán vectores cercanos en el espacio matemático.
Esto es lo que permite que cuando un cliente pregunte "¿puedo devolver un artículo roto?", el sistema encuentre el fragmento correcto de tu política de devoluciones aunque no use las mismas palabras exactas.
Comparativa de bases de datos vectoriales en 2026
| Solución | Tipo | Ideal para | Precio |
|---|---|---|---|
| Pinecone | SaaS managed | Equipos sin infra propia, escala grande | Desde $70/mes |
| Weaviate | Open source / Cloud | Búsqueda híbrida, multimodal | Free tier + cloud desde $25/mes |
| Supabase pgvector | PostgreSQL extension | Pymes que ya usan Supabase/Postgres | Incluido en plan Pro ($25/mes) |
| ChromaDB | Open source | Prototipado, proyectos pequeños | Gratis (self-hosted) |
| Qdrant | Open source / Cloud | Alto rendimiento, filtrado avanzado | Free tier + cloud desde $25/mes |
El mercado de bases de datos vectoriales alcanzó los $3.2 mil millones en 2025 y se proyecta que llegue a $8.3 mil millones para 2028, según MarketsandMarkets. No es una moda: es infraestructura que se está convirtiendo en estándar.
¿Cuál elegir para tu empresa?
La respuesta corta: depende de tu stack actual.
- Si ya usas Supabase o PostgreSQL: pgvector es la opción más natural. No añades complejidad ni costes — activas una extensión y listo
- Si necesitas escala y no quieres gestionar infraestructura: Pinecone o Weaviate Cloud te quitan el problema
- Si estás prototipando: ChromaDB es perfecto para validar la idea rápido con coste cero
- Si necesitas búsqueda híbrida (semántica + keyword): Weaviate destaca especialmente en este aspecto
5 casos de uso reales de RAG en empresas
RAG no es teoría. Las empresas que lo implementan están viendo resultados medibles. Según un informe de Gartner, para 2026 más del 60% de los proyectos de IA generativa empresarial incorporarán RAG como componente central.
1. Base de conocimiento interna
El caso más inmediato. Conectas todos tus documentos internos — manuales de procesos, políticas, guías técnicas — y creas un asistente que cualquier empleado puede consultar en lenguaje natural.
Impacto medido: empresas que implementan bases de conocimiento con RAG reportan una reducción del 35% en tiempo de onboarding de nuevos empleados y un 40% menos de preguntas repetitivas a managers y equipo senior (McKinsey Digital).
2. Soporte al cliente automatizado
En lugar de un chatbot con respuestas predefinidas, RAG permite crear un asistente que consulta tu documentación de producto, historial de tickets resueltos y FAQs en tiempo real para dar respuestas precisas y personalizadas.
Impacto medido: las empresas que usan RAG para soporte reportan una reducción del 40-60% en tickets de soporte nivel 1 y un aumento del 25% en satisfacción del cliente, según datos de Intercom.
3. Asistente de ventas y sales enablement
Tu equipo comercial tiene acceso instantáneo a fichas de producto, casos de éxito, objeciones frecuentes y datos competitivos. El sistema RAG recupera la información más relevante según el perfil del prospecto y la etapa del funnel.
Impacto medido: equipos de ventas con acceso a sistemas RAG cierran deals un 20% más rápido y reportan un 30% más de confianza en las propuestas generadas (Salesforce State of Sales).
4. Document Q&A para legal y compliance
Los departamentos legales manejan volúmenes enormes de contratos, regulaciones y políticas. RAG permite hacer preguntas en lenguaje natural sobre cualquier documento: "¿Qué cláusula de penalización tiene el contrato con Proveedor X?" y obtener la respuesta exacta con referencia al documento fuente.
5. Análisis de datos conversacional
Conecta RAG con tu base de datos SQL o tu data warehouse y permite que cualquier persona del equipo haga preguntas como "¿Cuáles fueron las ventas del Q4 por región?" sin saber SQL ni depender del equipo de datos. El sistema traduce la pregunta, consulta los datos y devuelve una respuesta en lenguaje natural.
Caso real — Empresas de nuestros casos de éxito ya están usando RAG como capa de datos en su Arquitectura Modular para automatizar soporte, ventas y operaciones internas. Descubre cómo funciona →
Los 6 errores que arruinan una implementación de RAG
Implementar RAG parece sencillo en los tutoriales. En producción, los detalles marcan la diferencia entre un sistema útil y uno que genera más problemas de los que resuelve.
1. Chunking incorrecto
El error más común. Si los fragmentos son demasiado grandes, el modelo recibe demasiada información irrelevante y pierde precisión. Si son demasiado pequeños, pierde contexto y las respuestas carecen de coherencia.
La regla práctica: fragmentos de 256-512 tokens con un overlap del 10-20% entre chunks consecutivos. Pero lo ideal es experimentar con tu tipo de contenido específico. Documentación técnica necesita chunks más grandes que FAQs.
2. Ignorar la metadata
No basta con indexar el texto. Cada fragmento necesita metadata: fecha del documento, departamento, tipo de documento, versión, producto al que se refiere. Sin metadata, el sistema no puede filtrar resultados ni priorizar información reciente sobre información obsoleta.
3. No actualizar los datos
Un sistema RAG con documentos desactualizados es peor que no tener RAG. Si tu política de precios cambió hace 3 meses pero el sistema sigue usando la versión anterior, cada respuesta incorrecta erosiona la confianza del equipo en la herramienta.
Solución: implementa un pipeline de actualización que reindexe documentos automáticamente cuando cambian. Con Arquitectura Modular, esta capa de datos se gestiona de forma independiente al resto del sistema.
4. Usar solo búsqueda semántica
La búsqueda semántica (por embeddings) es potente para entender la intención, pero falla con datos exactos: códigos de producto, nombres propios, números de referencia. La solución es hybrid search: combinar búsqueda semántica con búsqueda por keywords (BM25) y ponderar los resultados. Según Weaviate, la búsqueda híbrida mejora la precisión entre un 15% y un 30% en comparación con búsqueda semántica pura.
5. No evaluar la calidad de las respuestas
Muchas empresas lanzan RAG y se olvidan. Sin un sistema de evaluación, no sabes si las respuestas son correctas, incompletas o directamente erróneas. Implementa métricas como:
- Faithfulness: ¿la respuesta se basa realmente en los documentos recuperados?
- Relevance: ¿los documentos recuperados son pertinentes a la pregunta?
- Answer completeness: ¿la respuesta cubre toda la información necesaria?
Herramientas como RAGAS (open source) permiten automatizar esta evaluación.
6. Saltar la fase de arquitectura
El error más caro a largo plazo. Si montas RAG sin pensar en cómo encaja en tu stack general, terminas con un sistema aislado que no se conecta bien con el resto de herramientas. Con Arquitectura Modular, RAG es simplemente la capa de datos inteligente que se conecta con tu capa de lógica — por ejemplo, agentes de IA empresariales — y tu capa de interfaz (chat, dashboard, API).
RAG como capa de datos en la Arquitectura Modular
Si has leído sobre Arquitectura Modular en este blog, ya sabes que estructuramos los sistemas de empresa en capas independientes e intercambiables. RAG encaja perfectamente como la capa de datos inteligente:
- Capa de datos (RAG): tus documentos, bases de datos y conocimiento interno indexado en una base vectorial, listo para ser consultado por cualquier componente del sistema
- Capa de lógica (Agentes IA): los agentes consultan la capa RAG para tomar decisiones informadas, en lugar de depender de su entrenamiento genérico
- Capa de ejecución: las acciones que se ejecutan basadas en las decisiones informadas por RAG — enviar emails, actualizar CRM, crear tickets. Protocolos como MCP (Model Context Protocol) estandarizan estas conexiones
- Capa de interfaz: chatbots, dashboards o APIs donde los humanos interactúan con el sistema
La ventaja clave: si mañana quieres cambiar de Pinecone a Weaviate, o de OpenAI Embeddings a Cohere, solo sustituyes la capa de datos. El resto del sistema sigue funcionando sin cambios. Eso es modularidad real.
El stack RAG que recomendamos en 2026
Basándonos en proyectos reales con clientes, esta es la combinación que mejor funciona para pymes:
- Base vectorial: Supabase pgvector (si ya usas Supabase) o Weaviate Cloud (si necesitas búsqueda híbrida avanzada)
- Embeddings: OpenAI text-embedding-3-small (mejor relación calidad/precio) o Cohere embed-v3 (mejor para contenido multilingüe)
- Orquestación: LangChain o LlamaIndex para gestionar el pipeline de ingestión y recuperación
- Modelo generativo: GPT-4o o Claude 3.5 para la generación final de respuestas
- Evaluación: RAGAS para monitorizar calidad de respuestas de forma continua
¿Montar RAG tú mismo o usar una plataforma?
Esta es la pregunta del millón. Y la respuesta, como siempre, es: depende. Pero aquí van datos concretos para que puedas decidir.
Opción A: Implementación propia (DIY)
Montar tu propio pipeline RAG con LangChain/LlamaIndex + una base vectorial + APIs de embeddings.
- Ventajas: control total, personalización completa, sin dependencia de terceros, costes variables (pagas solo por uso)
- Desventajas: requiere equipo técnico, tiempo de desarrollo (2-6 semanas para un MVP), mantenimiento continuo
- Coste estimado: $50-200/mes en infraestructura + tiempo de desarrollo
Opción B: Plataformas RAG-as-a-Service
Usar plataformas que abstraen toda la complejidad técnica:
- Vectara: RAG completo out-of-the-box con grounding y anti-alucinación integrado. Ideal para empresas que quieren resultados rápidos
- Relevance AI: plataforma no-code para crear agentes con RAG integrado. Muy buena UX, perfecta para equipos no técnicos
- Stack AI: builder visual de workflows con RAG. Combina la facilidad de Make con la potencia de RAG
Nuestra recomendación
Para la mayoría de pymes, el camino más inteligente es empezar con una plataforma para validar el caso de uso en 1-2 semanas, y migrar a implementación propia cuando el ROI esté demostrado y necesites más control. Con Arquitectura Modular, esa migración es simplemente cambiar un bloque — sin reconstruir todo el sistema.
El ROI real de RAG: datos que lo respaldan
Implementar RAG no es un experimento — es una inversión con retorno medible. Estos son los datos que estamos viendo en el mercado:
- 40-60% de reducción en tickets de soporte nivel 1 en empresas que usan RAG para atención al cliente (Intercom AI Report)
- 67% de reducción en alucinaciones comparado con modelos sin RAG, según investigaciones publicadas en arXiv
- ROI de 3.5x en el primer año para implementaciones RAG enfocadas en soporte y ventas (Forrester TEI Report)
- 35% menos de tiempo en onboarding de nuevos empleados cuando tienen acceso a un asistente RAG con la documentación interna (McKinsey)
- $4.4 billones anuales es el impacto económico estimado de la IA generativa, del cual RAG es un componente central según McKinsey
El patrón es claro: las empresas que conectan su IA con datos reales obtienen resultados exponencialmente mejores que las que usan IA genérica. Y la diferencia no está en el modelo que usan — está en la arquitectura de datos que hay detrás.
Cómo empezar con RAG en tu empresa: plan de 4 semanas
No necesitas un equipo de 10 ingenieros ni 6 meses de desarrollo. Este es el plan que seguimos con nuestros clientes:
Semana 1: Auditoría de datos
- Identifica los 3-5 repositorios de conocimiento más consultados en tu empresa (manuales, FAQs, documentación de producto)
- Evalúa la calidad: ¿están actualizados? ¿están en formato digital? ¿tienen estructura?
- Define el primer caso de uso: soporte al cliente, base de conocimiento interna o asistente de ventas
Semana 2: Pipeline de ingestión
- Configura el proceso de chunking y embeddings para tus documentos
- Carga los datos en tu base vectorial elegida
- Implementa metadata relevante: fecha, departamento, tipo de documento, versión
Semana 3: Prototipo funcional
- Conecta el pipeline de recuperación con un modelo generativo
- Crea una interfaz simple (puede ser un chatbot en Slack, una página web o una API)
- Prueba con 50-100 preguntas reales del equipo y mide la precisión
Semana 4: Iteración y lanzamiento
- Ajusta el tamaño de chunks, el número de documentos recuperados y los prompts del sistema
- Implementa feedback loop: que los usuarios puedan marcar respuestas como correctas o incorrectas
- Lanza para un grupo piloto y mide métricas de adopción y satisfacción
Con Arquitectura Modular, este proceso es aún más rápido porque ya tienes los datos estructurados y las capas bien definidas. RAG se añade como un nuevo bloque sin afectar al resto del sistema.
¿Quieres conectar tu IA con los datos reales de tu empresa?
RAG es la pieza que transforma una IA genérica en un asistente que realmente entiende tu negocio. Con Arquitectura Modular, lo implementamos como un bloque más de tu sistema — sin disrupciones, con resultados medibles.
Descubre cómo funciona la Arquitectura Modular
Preguntas frecuentes sobre RAG empresarial
¿Qué es RAG y en qué se diferencia de usar ChatGPT directamente?
RAG (Retrieval-Augmented Generation) es una arquitectura que conecta un modelo de IA con tus datos internos. A diferencia de ChatGPT genérico, un sistema RAG busca primero en tu base de conocimiento — documentos, manuales, CRM — y luego genera respuestas basadas en información real y actualizada de tu empresa, reduciendo alucinaciones hasta en un 67%.
¿Qué tipo de datos puede usar un sistema RAG empresarial?
Prácticamente cualquier tipo de documento: PDFs, manuales internos, emails, tickets de soporte, contratos, bases de datos SQL, wikis internas, conversaciones de Slack, grabaciones transcritas y datos de CRM. La clave está en un buen proceso de chunking (fragmentación) y generación de embeddings que capture el significado semántico del contenido.
¿Cuánto cuesta implementar RAG en una pyme?
Los costes varían según el volumen de datos. Con herramientas open source como ChromaDB o la extensión pgvector de Supabase, el coste de infraestructura puede empezar desde 0-50 euros al mes. Las APIs de embeddings cuestan entre 0.02 y 0.13 dólares por millón de tokens. El mayor coste es la implementación inicial: estructurar datos, configurar el pipeline y optimizar la recuperación. El ROI medio es de 3.5x en el primer año.
¿RAG reemplaza la necesidad de hacer fine-tuning?
En la mayoría de casos empresariales, sí. El fine-tuning modifica el modelo permanentemente y requiere reentrenamiento cada vez que cambian los datos. RAG mantiene el modelo base intacto y actualiza el conocimiento simplemente añadiendo o modificando documentos en la base vectorial. Es más flexible, más barato y más fácil de mantener. El fine-tuning solo tiene sentido cuando necesitas cambiar el estilo o comportamiento del modelo, no para inyectar conocimiento factual.
¿Qué errores comunes se cometen al implementar RAG?
Los errores más frecuentes son: chunks demasiado grandes o pequeños (el tamaño óptimo es 256-512 tokens), no incluir metadata en los documentos, ignorar la frescura de los datos, no implementar un sistema de evaluación de calidad, y usar un solo tipo de búsqueda en lugar de combinar búsqueda semántica con keyword search (hybrid search). También es crítico no saltar la fase de arquitectura — sin estructura modular, el sistema RAG queda aislado y es difícil de mantener.
¿Necesito programar para montar un sistema RAG?
No necesariamente. Plataformas como Relevance AI, Vectara o Stack AI permiten crear pipelines RAG sin código. Sin embargo, para una implementación personalizada y optimizada, tener conocimientos técnicos o trabajar con un equipo especializado marca la diferencia. Lo más importante es tener los datos bien estructurados — ahí es donde entra la Arquitectura Modular.